How LLMs Work: Just Enough to Build With Them - Episode 03
 NR
@noyonrahman
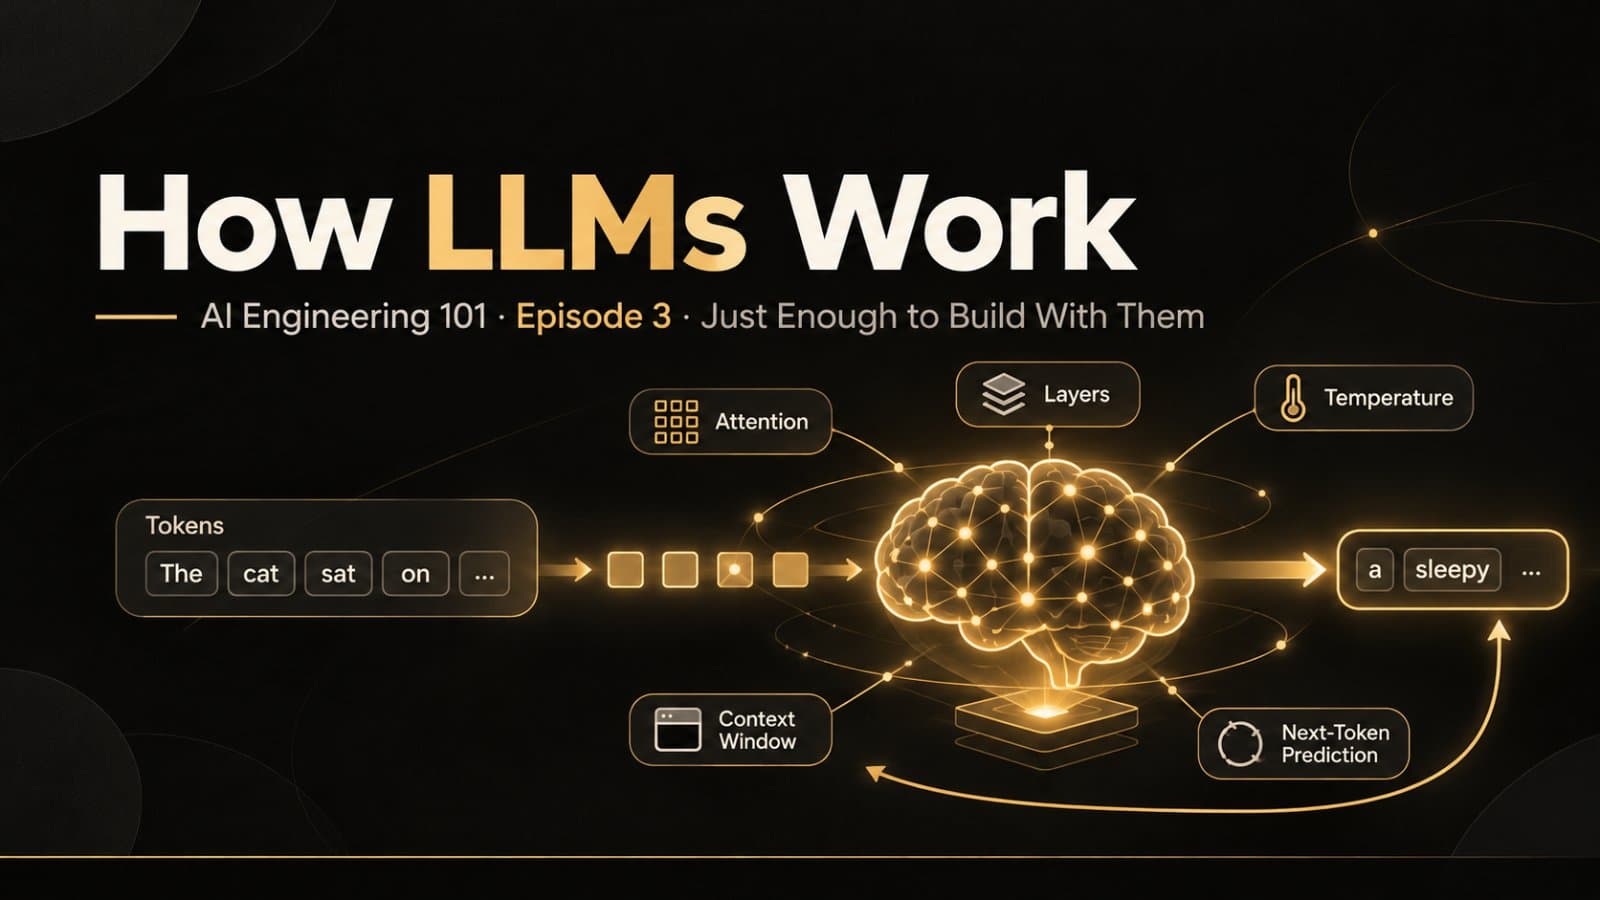
Episode 1 এ আমরা দেখেছি AI Engineering আসলে কী। Episode 2 তে দেখেছি classical ML থেকে agentic system পর্যন্ত আমরা কীভাবে এলাম। এই episode এ আমরা সোজা বাক্সের ভেতরে তাকাব। বাক্সটার নাম LLM।
একটা কথা শুরুতেই পরিষ্কার করে নেওয়া ভালো। এই episode এর উদ্দেশ্য transformer বানানো শেখা না। ভেতরের math, training এর details, এসব আমাদের লাগবে না। আমাদের দরকার খুব bare minimum: LLM জিনিসটা কী, এর terminology গুলো কী, এটা কীভাবে কাজ করে, আর এটা আমাদের জন্য কোথায় কোথায় gap রেখে গেছে, যেখানে engineering করতে হবে।
বাক্সটা খুলে দেখব কেন?
প্রতিদিন নতুন model আসছে। কোনোটা কয়েকশ billion parameter, কোনোটা trillion, কোনোটার context window বিশাল। এই শব্দগুলো আমরা সবাই শুনেছি। কিন্তু কিছু সাধারণ প্রশ্নের উত্তর কি আমরা সত্যিই জানি?
Create an account to read the full article.
The author made this article available to TechTipsHub members. It takes a moment to join, and you can read everything on the site.
Already have an account? Sign in
Episode 1 এ আমরা দেখেছি AI Engineering আসলে কী। Episode 2 তে দেখেছি classical ML থেকে agentic system পর্যন্ত আমরা কীভাবে এলাম। এই episode এ আমরা সোজা বাক্সের ভেতরে তাকাব। বাক্সটার নাম LLM।
একটা কথা শুরুতেই পরিষ্কার করে নেওয়া ভালো। এই episode এর উদ্দেশ্য transformer বানানো শেখা না। ভেতরের math, training এর details, এসব আমাদের লাগবে না। আমাদের দরকার খুব bare minimum: LLM জিনিসটা কী, এর terminology গুলো কী, এটা কীভাবে কাজ করে, আর এটা আমাদের জন্য কোথায় কোথায় gap রেখে গেছে, যেখানে engineering করতে হবে।
বাক্সটা খুলে দেখব কেন?
প্রতিদিন নতুন model আসছে। কোনোটা কয়েকশ billion parameter, কোনোটা trillion, কোনোটার context window বিশাল। এই শব্দগুলো আমরা সবাই শুনেছি। কিন্তু কিছু সাধারণ প্রশ্নের উত্তর কি আমরা সত্যিই জানি?
- কেন token ধরে pay করতে হয়? উত্তর আছে Tokens এ।
- কেন একই প্রশ্নে দুইবার দুই রকম উত্তর আসে? উত্তর Temperature এ।
- কেন উত্তর একবারে না এসে একটু একটু করে stream হয়? উত্তর Generation loop এ।
- কেন দুইটা request এর মধ্যে কিছুই মনে রাখে না? উত্তর Context window এ।
- কেন জেনেশুনে (আসলে না জেনে) এত confidently ভুল কথা বলে? উত্তর Prediction এর মধ্যেই।
AI Engineer হতে চাইলে এই প্রশ্নগুলোর উত্তর জানা দরকার। এই episode এ tokens, temperature, generation loop, context window, hallucination, সব একসাথে আসবে। সাথে বুঝব "70B parameter" বলতে আসলে কী বোঝায়, বেশি parameter হলে ভালো কি না, আর pricing কীভাবে কাজ করে, যাকে বলে token economy।
আগে একটা বাক্স পূরণ করুন
The cat sat on the ___
এটা ছোটবেলার fill in the blank। আপনার মাথায় নিশ্চয়ই কিছু একটা এসেছে। mat, বা sofa, বা chair। লক্ষ করুন, আপনি কোথাও খুঁজতে যাননি। আপনার brain সরাসরি predict করেছে পরের word কী হবে।
LLM ঠিক এই কাজটাই করে। সারা দুনিয়া নাড়িয়ে দিচ্ছে, এত এত product বানাচ্ছে, কিন্তু ভেতরে চলছে মাত্র একটাই কাজ।
An LLM does one thing. It predicts what comes next.
আর সেটা character না, word না, token। আপনি যে SQL query লেখাচ্ছেন, যে email লেখাচ্ছেন, যে software বানাচ্ছেন, সব জায়গায় একই ধাপ বারবার repeat হচ্ছে: পরের token কী হবে।
এক বাক্য, পাঁচ ধাপ
একটা বাক্স থেকে উত্তর বের হতে transformer architecture পাঁচটা ধাপ পার করে:
- Tokens: text কে ছোট ছোট chunk এ কাটে
- Meaning: প্রতিটা chunk কে number এ রূপান্তর করে
- Attention: কোন word কতটা গুরুত্বপূর্ণ, সেটা বের করে
- Layers: একই জিনিস বারবার refine করে
- Scores: সম্ভাব্য প্রতিটা পরের word কে score দেয়
তারপর একটা word বেছে নেয়, বাক্সে জুড়ে দেয়, আর আবার শুরু করে। এবার একটা একটা করে দেখি।
Step 1: Tokens
Model শব্দ পড়ে না, chunk পড়ে। এই chunk টাই token।
Text | Tokens | সংখ্যা |
|---|---|---|
TaskFlow creates tasks |
| 4 |
engineering |
| 1 |
anthropomorphization |
| 3 |
anthropomorphization একটা শব্দ, কিন্তু model এটাকে তিন টুকরো করে। উচ্চারণ ঠিক হলো কি না সেটা আমাদের দেখার বিষয় না, কিন্তু tokenization দেখার বিষয়।
প্রতিটা token এর জন্য একটা করে number ঠিক করা আছে। যেমন Task হলো 6396, Flow হলো 11951, creates হলো 11705, tasks হলো 9079। প্রতিটা model এর নিজস্ব একটা fixed তালিকা আছে, যাকে বলে vocabulary। আর tokenization এর কোনো একটাই universal পদ্ধতি নেই। এক এক model এক এক ভাবে token বানায়। পুরনো model এর tokenizer অনেক বেশি token বানাত। আধুনিক model গুলো বড় বড় chunk বানায়, ফলে token খরচ কমে।
অনেকটা rule of thumb হিসেবে, ইংরেজিতে একটা token প্রায় তিন-চতুর্থাংশ word। মানে 1000 token মোটামুটি 750 word।
একই বাক্য, Bangla তে বেশি খরচ
এই জায়গাটা আমাদের নিজেদের জন্য জরুরি। AI এর পুরো concept ইংরেজিকে ভিত্তি করে গড়ে উঠেছে। বাংলা নিজেই একটা কঠিন ভাষা, আর একটা বাংলা শব্দ represent করতে অনেকগুলো Unicode character লাগে। তাই একই কথার জন্য বাংলায় অনেক বেশি token লাগে।
- English: I love my country, 4 tokens
- Bangla: আমি আমার দেশকে ভালোবাসি, 11 tokens
কিছু model এ এটা আরও বেশি হতে পারে। সবটাই নির্ভর করে model এর tokenizer এর ওপর। নিজে হাতে দেখতে চাইলে tiktokenizer.vercel.app এ গিয়ে বিভিন্ন model দিয়ে একই text দিয়ে দেখুন। কোনো model বাংলা tokenize করতে পারে, কোনোটা ভালো পারে না। আরেকটা মজার জিনিস, পুরনো model এ একই শব্দ বেশি token এ ভাঙে।
এটা বোঝা জরুরি, কারণ আপনার bill হবে token এর ওপর। AI product এ কত টাকা খরচ হতে পারে সেই economics বুঝতে চাইলে আগে বুঝতে হবে token কীভাবে তৈরি হচ্ছে।
Step 2: Meaning
Token গুলো number হওয়ার পর সেগুলো একটা map এ বসে। Word হয়ে যায় map এর বিন্দু।
- kitten, cat, puppy, dog, horse থাকে এক জায়গায় (animals)
- pizza, bread, rice, mango থাকে আরেক জায়গায় (food)
- car, bus, train থাকে আরেক জায়গায় (vehicles)
যে শব্দগুলো কাছাকাছি, সেগুলো একই ধরনের জায়গায় ব্যবহার হয়। এই map ই model কে meaning খুঁজে পেতে সাহায্য করে।
Step 3: Attention
এটাই transformer এর সবচেয়ে গুরুত্বপূর্ণ ধারণা।
The cat sat on the mat because it was tired.
এই it কাকে বোঝাচ্ছে, cat কে না mat কে? মানুষ সহজেই বুঝে ফেলে এটা cat। কিন্তু machine কীভাবে বুঝবে? এই বুঝতে পারাটাই attention। সব word এর গুরুত্ব সমান না, আর model শেখে কোন word এ বেশি মনোযোগ দিতে হবে।
আরেকটা উদাহরণ, bank।
- I sat by the river bank: এখানে bank মানে নদীর পাড়
- I put my cash in the bank: এখানে bank মানে টাকা রাখার জায়গা
শব্দ একই, অর্থ আলাদা। Attention প্রতিটা word কে আশেপাশের word থেকে meaning ধার নিতে দেয়।
Step 4: Layers
এই কাজটা model একবার করে থেমে যায় না। Layer এর পর layer, একই জিনিস বারবার refine করে। The cat sat on the ___ এ প্রতিটা layer এ best guess এভাবে বদলাতে পারে:
Layer | Best guess | Confidence |
|---|---|---|
Early | floor | 12% |
Middle | sofa | 25% |
Late | mat | 41% |
Final | mat | 62% |
প্রথমে floor, তারপর sofa, শেষে mat, আর confidence বাড়তে বাড়তে 62% এ পৌঁছায়।
Step 5: Scores
শেষ ধাপে model প্রতিটা সম্ভাব্য পরের word কে একটা score দেয়।
- mat: 62%
- sofa: 20%
- roof: 8%
- floor: 6%
- moon: 0.1%
যার score সবচেয়ে বেশি, সাধারণত সেটাই বসে। এখানে একটা কথা মাথায় গেঁথে রাখুন: এই র্যাংকিংয়ে সত্য-মিথ্যার কোনো জায়গা নেই। Model এর কাছে "ঠিক" বা "ভুল" বলে কিছু নেই। আছে শুধু, আমার prediction এ কোন token সবার ওপরে। যদি sofa সবার ওপরে থাকত, output হতো sofa।
Temperature: একটাই knob
প্রশ্ন আসে, সবসময় সবচেয়ে বেশি score এর word ই কেন বসে না? এখানেই আসে temperature, model কতটা সাহসী হয়ে বেছে নেবে তার নিয়ন্ত্রণ।
- Temperature 0: focused, সবচেয়ে কম creativity, শক্ত তথ্য নিয়ে কাজ করে
- Temperature বাড়ালে: বেশি variety, বেশি creative
কোন কাজে কোন setting:
Low (একই input, একই output) | Higher (বেশি variety) |
|---|---|
Data pull করা | Brainstorming |
Label এ ভাগ করা | First draft |
Tool call করা | Creative writing |
একটা কথা মনে রাখবেন: প্রতিটা output sample করা হয়, compute করা হয় না। Low temperature এও একই প্রশ্নে সবসময় একই উত্তর পাওয়ার গ্যারান্টি নেই। তাই output কে কখনো "হিসাব করা ফলাফল" ধরে নেবেন না।
The generation loop
এই পুরো ব্যাপারটা একটা loop হিসেবে চলে: predict করো, একটা বেছে নাও, বাক্সে জুড়ে দাও, আবার করো। The cat sat on the mat and fell asleep. এভাবে এক এক করে তৈরি হয়, যতক্ষণ না stop আসে।
এই loop টা বুঝলে তিনটা জিনিস পরিষ্কার হয়ে যায়।
১. Reply stream হয়। প্রতিটা word একটা নতুন pass। পুরোটা একবারে বানিয়ে দিতে গেলে অপেক্ষা করতে হতো, তাই যেই word তৈরি হয়, সেটাই পাঠিয়ে দেওয়া সহজ। এজন্য AI সাধারণত streaming এ কাজ করে।
২. যত লম্বা, তত খরচ। প্রতিটা নতুন token বানানোর সময় আগের পুরোটা আবার ঘুরে দেখতে হয়। context যত বড়, সময় আর টাকা তত বেশি।
৩. No backspace. এটা সবচেয়ে interesting। ধরুন model লিখে ফেলল "mat", অথচ আসলে বিড়াল ছিল sofa র ওপর। এখন আর সে ফিরে গিয়ে ঠিক করতে পারে না। পরের পুরো journey টা সে ওই ভুল word এর ওপর ভিত্তি করেই চালিয়ে যাবে। থামার judgment তার নেই।
Multimodal: ছবিও token
এতক্ষণ text এর কথা বললাম। Multimodal model ও একই ভাবে কাজ করে। ছবি, audio, video, সবকিছুকেই token এ রূপান্তর করে নেয়। ছবির প্রতিটা patch একটা token। একই chat এ screenshot দিয়ে প্রশ্ন করা যায় ঠিক এই কারণেই। নতুন senses, কিন্তু একই machine, একই rules।
GPT নামটা এখন পড়তে পারবেন
- Generative: একটা একটা token করে text বানায়
- Pre-trained: বিশাল পরিমাণ text পড়ে শেখা
- Transformer: tokens, meaning, attention, layers, scores
Parameters: "70B" মানে 70 billion ছোট dial
Model এর নামের সাথে যে "70B" লেখা থাকে, সেটা 70 billion parameter। সহজ ভাবে বুঝুন: এগুলো ছোট ছোট dial। এই dial গুলোর ভেতরেই model এর সব জ্ঞান ছড়িয়ে আছে। কোথাও কিছু lookup করার নেই, কোনো আলাদা database নেই। Model যখন কাজ করে, এই dial গুলো connect করেই output বানায়।
- Training এর সময় dial গুলো সরে যায়, সাজানো হয়
- Inference এর সময় dial গুলো frozen
এজন্য একটা already trained model কে বদলানো বা retrain করা খুব কঠিন।
প্রতিটা model দুইবার বাঁচে
Training | Inference |
|---|---|
অন্য কারও কাজ | আমাদের কাজ |
Dial set করা হয় | Dial frozen |
কয়েক মাস, একবার, প্রতি version এ | প্রতি token এ কয়েক millisecond |
হাজার হাজার GPU | একটা API call |
ML researcher রা বিশাল data দিয়ে model train করেন। কয়েক মাস লাগে, প্রচুর GPU খরচ হয়। আমরা সেই model production এ deploy করি বা API দিয়ে call করি। আমরা যখন "hey, how are you?" পাঠাই আর উত্তর আসে, সেই কাজটার নামই inference। আমাদের ক্ষেত্রে এটাই জব।
Pretraining আর post-training
Training এর আবার দুটো ধাপ।
Pretraining এর পর model শুধু pattern match করে। What is the capital of France? দিলে সে হয়তো উত্তর না দিয়ে লিখবে What is the capital of Germany? What is the capital of Spain?, কারণ সে ভাবছে এই pattern টা চালিয়ে যেতে হবে। জ্ঞান আছে, কিন্তু উত্তর দেওয়ার behavior নেই।
Post-training এর পর একই প্রশ্নে সে বলে Paris।
Pretraining gives it knowledge. Post-training gives it manners.
Knowledge cutoff
প্রতিটা model একটা নির্দিষ্ট তারিখ পর্যন্ত data দিয়ে train হয়। ধরুন data নেওয়া হলো June 2026 পর্যন্ত। তাহলে এর পরের কিছুই model জানে না। এটাই cutoff। গতকালের খবর, আপনার নিজের data, কিছুই সে দেখেনি। Real time কিছু জানে না।
Context window
Context window হলো model এক সময়ে যতটুকু token নিতে পারে তার সীমা। কিন্তু এখানে ভুল ধারণা আছে। আপনি লিখছেন "hey, how are you?", কিন্তু model এর কাছে যাচ্ছে শুধু এটুকু না। সেই window এর ভেতরে থাকতে পারে:
- Instructions
- এ পর্যন্ত chat
- Documents
- Tool call এর response
- পুরনো memory
- আর তার নিজের reply
Window এর বাইরের সবকিছু model এর কাছে নেই। গতকালের chat, আপনার database, আজকের খবর, কিছুই না।
সবচেয়ে বড় surprise
Model দুইটা request এর মধ্যে কিছুই মনে রাখে না। প্রতিটা call একটা first meeting।
তাহলে ChatGPT বা অন্য chat app এ "memory" দেখি কীভাবে? উত্তর হলো app প্রতিবার পুরো chat টা আবার পাঠিয়ে দেয়।
- Request 1:
Hi, I'm Rafi.(1 message) - Request 2:
Hi, I'm Rafi.+Hello, Rafi!+What's my name?(3 messages) - Request 3: আগের সব +
You're Rafi.+Thanks!(5 messages)
আপনি দেখছেন ছোট একটা message পাঠাচ্ছেন, কিন্তু পেছনে প্রতিবার token এর size দ্বিগুণ, তিনগুণ হয়ে যাচ্ছে। LLM আসলে REST API এর মতো একদম stateless। ওর মাথায় memory নেই। প্রতিবার মনে করিয়ে দিতে হয়। পাঁচ-দশ-পনেরোটা message পর পুরনো message compress করতে হয়, আর এই নিয়ে নতুন নতুন technique আসছে। কিন্তু মূল কথা একই: প্রতিটা নতুন message context বাড়ায়, আর context বাড়া মানে cost বাড়া।
আপনি যে memory দেখেন, সেটা model এর ভেতরে না। সেটা model এর চারপাশে বানানো।
আসল সমস্যা: না জানলেও উত্তর দেয়
Model যে অনেক কিছু জানে না, সেটা সমস্যা না। সমস্যা হলো না জেনেও সে উত্তর দিয়ে যায়।
চায়ের দোকানে এমন একজন থাকেন না, যিনি সবকিছু জানেন? যে বিষয়েই কথা উঠুক, মনের মতো বানিয়ে ফেলেন। LLM হলো সেই চায়ের দোকানের মানুষটা। তার সামনে একটা word এসেছে, সে পরের word predict করেছে, তারপর নিজের মতো করে বলেই যাচ্ছে।
এটাই hallucination।
ভেতরে কী ঘটে? ধরুন জিজ্ঞেস করলাম: TaskFlow এর refund window কত? Model লেখা শুরু করল Refunds are allowed for 30, তারপর পরের token এর score:
- days: 93%
- hours: 3%
- weeks: 2%
- months: 1%
Clear winner। days বসে গেল। এখন আগের guess এর ওপর ভিত্তি করে পরের বাক্যও আবার sure sounding হবে। থামার ক্ষমতা তার নেই, তাই সে guess করে যায়।
Spot the fake
- Real: Where is the Eiffel Tower? উত্তর: In Paris, France.
- Made up: What's TaskFlow's refund window? উত্তর: 30 days, on every plan.
দুটো উত্তরই একই রকম confident। Model এর ভেতরে "আমি এটা বানিয়েছি" বলে কোনো flag নেই। আপনার কাছে আসল তথ্য না থাকলে আপনি বুঝতেই পারবেন না কোনটা fake।
এই কারণেই AI Engineering course এর অর্ধেকটা এই সমস্যার জন্য। Model ভুল উত্তর দিলে চলবে না, তাই ওর চারপাশে engineering করতে হয়:
সমাধান | কী করা হয় | Episode |
|---|---|---|
Ground it in facts | আগে ঠিক document টা এনে দেওয়া | EP 6 |
Give it tools | নিজে খুঁজে দেখতে দেওয়া | EP 7 |
Measure it | code test করার মতো করে উত্তর test করা | EP 9 |
Guard it | কাজ করার আগে output check করা | EP 5, 10 |
Keep a human in | ঝুঁকিপূর্ণ ধাপে মানুষের approval | EP 8, 10 |
প্রতিটা limit, একটা engineering কাজ
এই episode এর সবচেয়ে কাজের table টা হয়তো এটা। LLM এর যা যা সীমাবদ্ধতা, প্রতিটাই আমাদের জন্য কাজ।
Limit | মানে | কোথায় সমাধান |
|---|---|---|
প্রতিবার আলাদা | একই প্রশ্ন, নতুন উত্তর | EP 9: low temperature, evals |
Call এর মধ্যে ভুলে যায় | প্রতিটা request blank থেকে শুরু | EP 5, 6: history আর memory |
Window সীমিত | ঠেসে ভরলে quality পড়ে যায় | EP 5: context engineering |
Knowledge frozen | Cutoff এর পর কিছু নেই | EP 6, 7: RAG আর tools |
বানিয়ে বলে | ভুল হলেও sure শোনায় | EP 6 থেকে 10: grounding, guardrails |
প্রতিটা token এ খরচ | লম্বা chat দামি হয়ে যায় | EP 4, 10: model routing |
Token economy নিয়ে একটা কথা আলাদা করে বলা দরকার। একটা company যখন AI product বানায়, তখন আগে থেকে ধরে নিতে হয় না যে real user এলে কত token burst করবে। কত user এর জন্য কত token খরচ হচ্ছে বা হতে পারে, সেটা আগে থেকে predict করা নিজেই একটা বড় engineering কাজ।
মূল কথাগুলো
Model ততটাই smart, যতটা ভালো আপনার context। সেই context manage করাই আপনার কাজ।
সবচেয়ে ভালো model ও যদি খারাপ context পায়, সে বোকার মতো আচরণ করবে। তাই context manage করা সবচেয়ে গুরুত্বপূর্ণ engineering।
আর একটা বাক্সে পুরো episode:
LLM পরের token predict করে। এই course এর বাকিটা সেই prediction কে ঘিরে engineering।
আজ আমরা যত product দেখি, যত tool, যত কিছু চাকরি খেয়ে ফেলার মতো শোনা যায়, সবকিছুর পেছনে কোনো না কোনো engineering আছে। Token predict করাটাই বিশাল কাজ, আর intelligence সেখান থেকেই আসছে। কিন্তু সেই intelligence কে ঠিক ভাবে ব্যবহার করে product বানানোর যে কাজ, সেটাই AI Engineering। পরের episode গুলোতে আমরা দেখব কোথায় কোন engineering কেন দরকার।
এই লেখা Stack Learner এর "AI Engineering 101" course এর Episode 3 থেকে নেওয়া আমার নোট। course এর সব credit Stack Learner এর। আপনি যদি পুরো জিনিসটা ঠিকভাবে শিখতে চান, তাদের কোর্সটা দেখার পরামর্শ রইল।
Was this useful?
Get the next one in your inbox
One email a month with the articles worth your time. No daily mail.
Written by
@noyonrahmanFull-Stack Developer
I'm Noyon Rahman — a software developer based in Dhaka, Bangladesh. I focus on backend development and API integration, designing and maintaining scalable APIs and integrating third-party services. I also contribute to frontend features when the team needs an extra pair of hands.
6 followersJoined Nov 30, 2024
Discussion
No comments yet
Join the discussion
Sign in to comment on this article. It takes a moment.
Be the first to comment
Questions and field notes are welcome. Help the next reader who finds this article.