The Model Landscape - Right Model. Right Task, Every Time - Episode 04
 NR
@noyonrahman
Episode 1-এ বলা হয়েছিল, LLM আসলে তেমন কিছু নয়, আসল কাজ তার চারপাশের engineering। কথাটি আংশিক সত্য। LLM যে একটি next token generator, এটি ঠিক। আর মূল কাজ যে engineering, সেটিও ঠিক। কিন্তু "LLM-এর কোনো গুরুত্ব নেই" কথাটি সঠিক নয়।
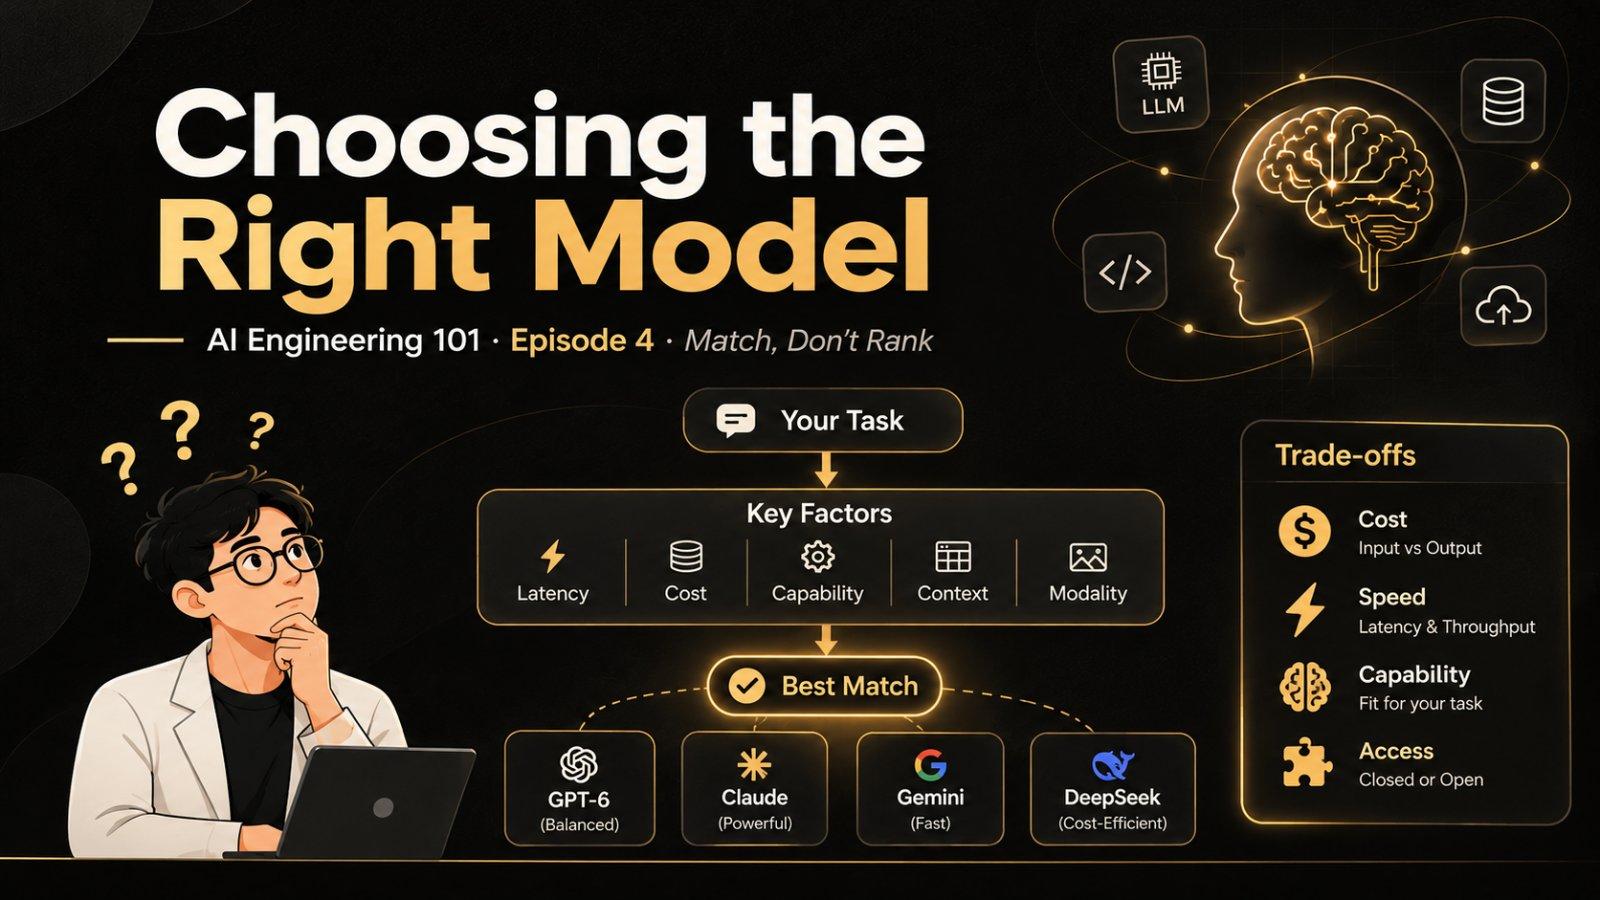
কারণ সব LLM-এর capability এক নয়। প্রতিটি model আলাদা, আর সেই কারণেই বড় বড় প্রতিষ্ঠান এতগুলো provider-এর পেছনে বিনিয়োগ করছে। এই পর্বে আমরা দেখব, একজন AI Engineer এত বিপুল সংখ্যক model-এর মধ্য থেকে কীভাবে সঠিকটি নির্বাচন করেন।
প্রতি সপ্তাহে নতুন একটি "best model"
একটি model gateway-র হিসাব অনুযায়ী (2026) বাজারে এখন 450+ model এবং 50+ provider রয়েছে। আমেরিকান ও চাইনিজ, সব প্রতিষ্ঠানই একে অপরের সঙ্গে প্রতিযোগিতা করছে। প্রতিটি launch-এর সঙ্গে একটি benchmark chart আসে, যেখানে নতুন model-এর bar সবচেয়ে উঁচু দেখানো হয়।
Create an account to read the full article.
The author made this article available to TechTipsHub members. It takes a moment to join, and you can read everything on the site.
Already have an account? Sign in
Episode 1-এ বলা হয়েছিল, LLM আসলে তেমন কিছু নয়, আসল কাজ তার চারপাশের engineering। কথাটি আংশিক সত্য। LLM যে একটি next token generator, এটি ঠিক। আর মূল কাজ যে engineering, সেটিও ঠিক। কিন্তু "LLM-এর কোনো গুরুত্ব নেই" কথাটি সঠিক নয়।
কারণ সব LLM-এর capability এক নয়। প্রতিটি model আলাদা, আর সেই কারণেই বড় বড় প্রতিষ্ঠান এতগুলো provider-এর পেছনে বিনিয়োগ করছে। এই পর্বে আমরা দেখব, একজন AI Engineer এত বিপুল সংখ্যক model-এর মধ্য থেকে কীভাবে সঠিকটি নির্বাচন করেন।
প্রতি সপ্তাহে নতুন একটি "best model"
একটি model gateway-র হিসাব অনুযায়ী (2026) বাজারে এখন 450+ model এবং 50+ provider রয়েছে। আমেরিকান ও চাইনিজ, সব প্রতিষ্ঠানই একে অপরের সঙ্গে প্রতিযোগিতা করছে। প্রতিটি launch-এর সঙ্গে একটি benchmark chart আসে, যেখানে নতুন model-এর bar সবচেয়ে উঁচু দেখানো হয়।
তাহলে কি পুরোনো model-গুলো অপ্রয়োজনীয় হয়ে যাচ্ছে? উত্তরটি নির্ভর করে আপনি কোন ভূমিকায় আছেন, তার ওপর।
সাধারণ ব্যবহারকারীর জন্য: এটি পছন্দের বিষয়
আপনি যদি শুধু chat ব্যবহার করেন, তাহলে benchmark দেখে আলোচনা বা তর্ক করতেই পারেন। যেমন, "আজ থেকে Opus 5.5 নয়, Fable 5.2 ব্যবহার করব।" কিন্তু বাস্তবে এতে বড় কোনো পার্থক্য হয় না। Dropdown থেকে যেকোনো model বেছে নিলে উত্তর কিছুটা ভালো বা কিছুটা কম ভালো আসবে, এর বেশি কিছু নয়। কোনো কিছু বিকল হবে না।
AI Engineer-এর জন্য: model হলো application-এর engine
কোনো product তৈরি করলে তার পেছনে একটি model থাকে, আর সেই model হাজার হাজার মানুষ ব্যবহার করেন। ভুল model বেছে নিলে মাস শেষে দেখা যেতে পারে, যে কাজ ১০০ ডলারে হওয়ার কথা ছিল, তার বিল এসেছে ৫০০ ডলার। শুধু একটি ভুল সিদ্ধান্তের কারণে।
একটি সিদ্ধান্তের ওপর চারটি বিষয় নির্ভর করে:
- Invoice: Model ভেদে input price-এ ২০ থেকে ১০০ গুণ পর্যন্ত পার্থক্য থাকে।
- Capability fit: প্রয়োজনের চেয়ে দুর্বল model কাজ সম্পন্ন করতে পারে না। আবার প্রয়োজনের চেয়ে শক্তিশালী model অকারণে অর্থ ব্যয় করায়।
- User experience: প্রথম শব্দ আসার আগের অপেক্ষার সময় (latency)।
- Dependency: Data কোথায় যাচ্ছে, এবং model পরিবর্তনের নিয়ন্ত্রণ কার হাতে।
Dependency-র একটি সহজ উদাহরণ দেওয়া যাক। Client স্পষ্টভাবে জানিয়েছেন যে data কোনোভাবেই বাইরে যাওয়া চলবে না, অথচ আপনি এমন একটি frontier model বেছে নিলেন, যা data বাইরের server-এ পাঠায়। এটিও একটি গুরুতর ভুল।
সবচেয়ে সাধারণ ভুল: সব কাজে frontier model ব্যবহার
বেশিরভাগ কাজে frontier model-এর প্রয়োজনই হয় না। Classify, Extract, Summarize, Route, এই কাজগুলো Haiku-class fast model দিয়েই সুন্দরভাবে করা যায়। এটি দ্রুত, সাশ্রয়ী এবং প্রয়োজনের জন্য যথেষ্ট।
একই কাজ Opus-class বা Fable-class model দিয়ে করালে শুধু input price-ই ২০ থেকে ১০০ গুণ বেশি পড়ে। Output price তো আলাদা। তা ছাড়া এগুলো reasoning model, তাই উত্তর আসতে বেশি সময় লাগে, আর user-কে অকারণে অপেক্ষা করতে হয়।
সামান্য একটি band-aid লাগানোর জন্য surgeon ডাকার প্রয়োজন হয় না।
Model-কে পড়ুন Bike-এর Spec Sheet-এর মতো
Model বোঝার জন্য একটি তুলনা আমার কাছে খুব কার্যকর মনে হয়েছে, যা বাংলাদেশের প্রায় সবাই সহজে বুঝবেন: bike showroom। Bike কিনতে গেলে showroom-এ যেমন বিভিন্ন spec সামনে রাখা হয়, model-এরও তেমন spec রয়েছে।
Bike showroom-এ | Model-এর spec sheet-এ |
|---|---|
Engine power, CC | Capability |
Mileage | Cost |
Top speed | Speed |
Standstill থেকে pickup | Latency |
Fuel tank-এর আকার | Context window |
কী কী বহন করতে পারে | Modality |
কিনবেন, নাকি ভাড়া নেবেন | Access |
সাতটি Parameter
- Capability: কী কী করতে পারে এবং কতটা ভালোভাবে।
- Cost: প্রতি million token-এর price, input ও output আলাদাভাবে।
- Speed: Generation শুরু হওয়ার পর প্রতি সেকেন্ডে কয়টি token আসে।
- Latency: প্রথম token আসতে কত সময় লাগে।
- Context: এক request-এ কতটা input গ্রহণ করতে পারে।
- Modality: Text, image, audio, video, document।
- Access: শুধু API, নাকি weights পাওয়া যায়, এবং license কী।
পৃথিবীর যেকোনো model-কে এই সাতটি দিয়েই মাপা যায়। এগুলো মনে রাখলে প্রতি সপ্তাহে নতুন model-এর পেছনে ছুটতে হবে না। নতুন model এলে আপনি নিজেই বুঝতে পারবেন, সেটি আপনার কাজের জন্য উপযুক্ত কি না।
Speed ও Latency এক বিষয় নয়
এ দুটি আলাদা ধরনের সমস্যা তৈরি করে। একটি উদাহরণ দেখা যাক (সময়গুলো উদাহরণস্বরূপ):
- Model A (4.8s): Low latency, কিন্তু slow speed। প্রায় সঙ্গে সঙ্গে লেখা শুরু করে, কিন্তু ধীর গতিতে লেখে।
- Model B (3.5s): High latency, কিন্তু fast speed। শুরুতে প্রায় তিন সেকেন্ড thinking করে, তারপর পুরো উত্তর অত্যন্ত দ্রুত তৈরি করে।
সহজভাবে বললে, প্রথম token আসার আগের অপেক্ষা হলো latency, আর তারপর কত দ্রুত token আসছে, সেটি হলো speed।
কোনো model-ই সাতটিতে সেরা হতে পারে না
এটি অনেকটা system design-এর মতো। একটি পেতে হলে আরেকটি ছাড়তে হয়। Capability বাড়ালে সাধারণত cost ও latency বাড়ে। Latency কমাতে গেলে capability কমে। বড় context window চাইলে অন্য কোনো বিষয়ে ছাড় দিতে হয়। অর্থাৎ model নির্বাচন মানে আসলে সিদ্ধান্ত নেওয়া, কোন বিষয়ে আপনি ছাড় দিতে প্রস্তুত।
Capability কোনো একক সংখ্যা নয়
আমরা সবাই "capability" শব্দটি ব্যবহার করি, কিন্তু এটি আসলে একটি সংখ্যা নয়। এটি একাধিক দক্ষতার সমন্বয়: coding, reasoning, tool use এবং ভাষা।
- Anthropic-এর Sonnet ও Opus coding-এ অত্যন্ত ভালো।
- GPT model-গুলো মূলত text generation ও কথোপকথনমূলক কাজের দিকে বেশি গুরুত্ব দিয়ে তৈরি। Coding-এর জন্য তাদের আলাদা model রয়েছে।
- সব model-এ বাংলা সমান ভালো কাজ করে না। কোনোটিতে ভালো ফল পাওয়া যায়, কোনোটিতে যায় না।
একটি কথা মনে রাখার মতো: কোনো leaderboard আপনার ভাষার মান যাচাই করে না। বাংলায় কোন model কেমন কাজ করে, তা জানতে নিজে পরীক্ষা করে দেখার বিকল্প নেই।
সময়ের সাথে সাথে এক একটি capability যুক্ত হয়েছে। প্রথমে reasoning ছিল না, তারপর এসেছে reasoning, তারপর tool use। আজ বেশিরভাগ model-ই multimodal এবং reasoning model।
Spec sheet বোঝার একটি উদাহরণ: Mixture of Experts (MoE)
"1.6T total / 49B active" লেখা দেখলে এর অর্থ কী? Trillion parameter-এর পুরো model একসঙ্গে চালানো hardware-এর জন্য কঠিন। তাই MoE পদ্ধতি ব্যবহার করা হয়। এখানে একটি বড় model-এর ভেতরে অনেকগুলো ছোট "expert" থাকে। Request-এর ধরন অনুযায়ী প্রতিটি token নির্দিষ্ট কয়েকটি expert-এর কাছে পাঠানো হয়।
- 1.6T total: মোট parameter, যার সবই সংরক্ষিত থাকে।
- 49B active: প্রতিটি token-এর জন্য বাস্তবে এটুকুই সক্রিয় থাকে।
এটি আজকের মূল আলোচনার অংশ নয়, তাই এখানেই শেষ করছি।
Buzzword-গুলো আসলে কোন parameter নির্দেশ করে
বাজারে যেসব প্রচলিত শব্দ শোনা যায়, প্রতিটিই আসলে কোনো না কোনো parameter-এর বর্ণনা:
শব্দ | কোন parameter |
|---|---|
Frontier | Capability |
Reasoning / Thinking | Capability, Cost, Latency |
Multimodal | Modality |
Open-weight | Access |
Fast / Small | Cost, Speed |
Specialist | আলাদা একটি শ্রেণি (এই ছকের বাইরে) |
এবার একটি একটি করে দেখা যাক।
Frontier: এটি একটি অবস্থান, কোনো product নয়
Frontier কোনো নির্দিষ্ট model নয়, এটি একটি অবস্থান। আজ Opus, GPT-6 top tier, Gemini Pro ও Grok frontier হিসেবে বিবেচিত। আগামী বছর নতুন model এলে এগুলো mid-tier-এ চলে যাবে। একসময় Sonnet-ও frontier ছিল, এখন আমরা Opus ও Fable-কে frontier বলি। এতে সমস্যার কিছু নেই। নতুন কেউ এলে সেই অবস্থান ছেড়ে দিতে হয়।
Reasoning: thinking একটি নিয়ন্ত্রণযোগ্য মাত্রা
আগে reasoning model আলাদা একটি শ্রেণি ছিল। এখন প্রায় প্রতিটি frontier model-এই reasoning built-in থাকে। Request-এর configuration-এ বলে দেওয়া যায়, কতটা thinking প্রয়োজন: Off, Low, High। Model একই, price list একই, শুধু কতটা প্রচেষ্টা করবে, তা আপনি ঠিক করেন। এক feature-এ thinking চালু রাখা যায়, আরেক feature-এ বন্ধ।
তিনটি বিষয় মনে রাখা প্রয়োজন:
- Thinking output হিসেবে bill হয়। Thinking-এর token আপনি দেখতে পান না, কিন্তু সেগুলো output token হিসেবে গণনা করা হয়। আর output token সাধারণত input token-এর চেয়ে কয়েক গুণ বেশি দামি।
- Thinking latency বাড়ায়।
- জটিল সমস্যার সমাধান আরও নির্ভুল হয়।
আগে উন্নতির প্রধান পথ ছিল আরও বড় model প্রশিক্ষণ দেওয়া। এখন নতুন একটি উপায় হলো, model-কে আরও বেশি সময় ভাবতে দেওয়া।
একটি উদাহরণ: "Q4 launch তিন সপ্তাহ পিছিয়ে গেল কেন?"
- Thinking off (1.8s, 0 thinking token): "সম্ভবত scope বেড়ে গেছে। Planning আরও সুসংহত করুন।" এটি একটি সাধারণ উত্তর।
- Thinking high (7.3s, 2400 thinking token, output হিসেবে bill): "Design review-এর কারণে API-র কাজ ১২ দিন আটকে ছিল।" এটি নির্দিষ্ট ও কাজে লাগার মতো উত্তর।
সময় বেড়েছে, খরচ বেড়েছে, উত্তরের মানও বেড়েছে। একটি মাত্রা পরিবর্তন করতেই তিনটি parameter একসঙ্গে বদলেছে।
দ্রুত পরীক্ষা: কোথায় thinking চালু করবেন?
Task | Thinking |
|---|---|
Email-এর সারাংশ করা | Off |
Ticket tag করা: bug নাকি feature? | Off |
Race condition debug করা | High |
তিন মাসের migration plan করা | High |
নিয়মটি সহজ: সমস্যায় গভীরভাবে ভাবার কিছু না থাকলে thinking tax দেবেন না।
Open-weight: Cake পাবেন, recipe নয়
Open-weight মানে open-source নয়। প্রতিষ্ঠানটি model প্রশিক্ষণ দিয়ে তার চূড়ান্ত artifact, অর্থাৎ trained weights, আপনাকে দিয়ে দেয়।
যা পাবেন: নিজের server-এ self-host করা, পরিবর্তন করা, fine-tune করা।
যা পাবেন না: training data, recipe, বিনামূল্যে hosting।
মনে রাখতে হবে, self-hosting মানে নিজেই নিজের provider হয়ে যাওয়া। Inference-এর অবকাঠামো ও খরচ সবই আপনার দায়িত্বে থাকে।
Open-weight model এখন মূলত চীনের প্রতিষ্ঠানগুলোর
- DeepSeek: অসাধারণ cost-efficiency, MIT license।
- Qwen: সবচেয়ে বিস্তৃত family, phone-এ চলার মতো ছোট model থেকে flagship পর্যন্ত।
- Kimi: Trillion-scale MoE, agentic coding-এ শক্তিশালী।
- GLM: Agentic coding-এর জন্য জনপ্রিয়, MIT license।
- MiniMax: উদ্ভাবনী নকশা, ছোট model-গুলো ভালো।
এগুলোর license উদার, context window million token পর্যন্ত, আর US frontier model-এর তুলনায় দাম অনেক কম।
এসব model আসার ফলে আমেরিকান প্রতিষ্ঠানগুলোর একচেটিয়া অবস্থান কমেছে, এবং এটি একটি ইতিবাচক পরিবর্তন। প্রতিযোগিতা না থাকলে দামের ওপর কোনো নিয়ন্ত্রণ থাকে না। কম খরচে ভালো সেবা পাওয়া গেলে ভবিষ্যতে বিভিন্ন প্রতিষ্ঠান এই model আরও বেশি ব্যবহার করবে, এমনটাই ধারণা করা যায়। শুধু দুটি আমেরিকান lab-এর নাম জানলে পুরো পরিস্থিতি বোঝা যায় না।
Fast / Small: যথেষ্ট সক্ষম, দুর্বল নয়
Haiku, Flash, mini, এগুলো সীমিত পরিসরের কাজের জন্য উপযুক্ত। যেমন ticket classify করা, due date বের করা, request route করা, thread-এর সারাংশ করা, ভাষা শনাক্ত করা। Production traffic-এর বড় অংশই এ ধরনের কাজ, আর এসবের জন্য গভীর thinking-এর প্রয়োজন হয় না।
আরও ছোট model Hugging Face-এ পাওয়া যায়, যেগুলো নিজে deploy করেও ব্যবহার করা যায়। অল্প খরচে product-এ অনেক কার্যকর feature যোগ করা সম্ভব। AI engineering নিয়ে পড়াশোনা এগোলে এগুলো পরীক্ষা করে দেখা উপকারী হবে।
Specialist: মূল ছকের পাশে আরেকটি শ্রেণি
একটি বাস্তব system কখনোই একটি model দিয়ে চলে না:
- Embedding model: Text থেকে vector তৈরি করে (EP-6)
- Reranker: প্রাসঙ্গিকতা অনুযায়ী মান নির্ধারণ করে (EP-6)
- Fast model: সারাংশ, tag, routing
- Big model + thinking: বিরল ও জটিল বিশ্লেষণ
তাই আসল প্রশ্নটি "কোন model?" নয়, বরং "কোথায় কোন model?"
Bike-এর ধাপ আর Model-এর ধাপ একই
প্রতিটি bike প্রস্তুতকারকের কাছে গেলে একই তিনটি শ্রেণি পাওয়া যায়:
- 110cc, Commuter: সাশ্রয়ী, দ্রুত, সর্বত্র সহজলভ্য।
- 150cc, All-rounder: সবচেয়ে বিবেচনাসম্মত সাধারণ পছন্দ।
- 300+cc, Big bike: সর্বোচ্চ শক্তি, সর্বোচ্চ দাম।
রাস্তায় বেশিরভাগ ১৫০সিসি bike চোখে পড়ে, ৩০০সিসি তুলনামূলক কম। Model-এর ক্ষেত্রেও তাই: Big, Balanced, Fast।
Lab | Big | Balanced | Fast |
|---|---|---|---|
Anthropic | Opus | Sonnet | Haiku |
OpenAI | GPT-6 top tier | GPT-6.1 mid-tier | mini, nano |
Gemini Pro | Flash, Flash-Lite | ||
DeepSeek | V4 Pro | V4 Flash | |
Alibaba Qwen | Max | Plus | Small open models |
Model-এর নাম বদলায়, কিন্তু ধাপগুলো একই থাকে। নতুন কোনো model এলে শুধু তিনটি বিষয় জেনে নিলেই যথেষ্ট:
- "Haiku 5.5" → Lab: Anthropic, Tier: Fast, Generation: নতুন।
- "Gemini Flash-Lite" → Lab: Google, Tier: Fast-এর নিচে।
একটি কার্যকর পদ্ধতি উল্লেখ করা যায়। Opus ও Fable-এর পাশে Sonnet অনেক সময় কম নজর পায়, অথচ Sonnet অত্যন্ত শক্তিশালী। Agentic coding-এর ক্ষেত্রে planning-এর জন্য Opus এবং execution-এর জন্য Sonnet ব্যবহার করলে token অনেক সাশ্রয় হয়, সময়ও কমে।
The Matching Method: Match করুন, Rank নয়
যে সবচেয়ে সাশ্রয়ী tier প্রয়োজনীয় মান পূরণ করে, সেটিই বেছে নিন।
সাধারণ মানুষ আগে model বেছে নেন: "এটি দিয়েই আমার কাজ হবে।" AI Engineer আগে সমস্যাটি বিশ্লেষণ করেন, সমস্যার একটি profile তৈরি করেন, তারপর সেই profile-এর সঙ্গে model মেলান।
প্রথম ধাপ: সমস্যার profile তৈরি করুন
- Capability needed: কাজটি সীমিত পরিসরের, নাকি সত্যিই জটিল?
- Volume: ১০ বার, নাকি ১,০০,০০০ বার?
- Latency budget: User অপেক্ষা করছেন, নাকি কাজটি রাতে batch-এ চলবে?
- Context needed: এক অনুচ্ছেদ, নাকি ২০০ পৃষ্ঠা?
- Modality: শুধু text, নাকি image-ও?
- Data constraints: Data কি নিজের server-এর বাইরে যেতে পারবে?
Volume-এর হিসাবেই সবচেয়ে বেশি ভুল হয়। Development-এর সময় test করতে গেলে bill খুবই কম আসে। কিন্তু এক লক্ষ user যখন দিনে এক লক্ষ বার একই query চালাবেন, তখন হিসাব সম্পূর্ণ আলাদা হয়ে যায়। একজন user-এর জন্য ভুলবশত প্রতি request-এ ২ ডলার বেশি খরচ হলে, ১০০ জন ব্যবহার করলে সেটি ২০০ ডলারের ক্ষতি। তাই কতবার execute হতে পারে, তা আগেই ভেবে নেওয়া প্রয়োজন।
Context নিয়েও একটি কথা। Agent বা harness তৈরি করলে বারবার অনেক বড় context পাঠাতে হয়। সেখানে Haiku-র মতো model হয়তো যথেষ্ট নাও হতে পারে।
দ্বিতীয় ধাপ: Profile অনুযায়ী tier নির্ধারণ করুন
- সীমিত পরিসর, অনেক volume, কম latency → Fast tier
- সাধারণ product-এর কাজ → Balanced tier
- সত্যিই জটিল, একাধিক ধাপের, বিরল → Big tier, thinking on
- Data নিজের server-এর বাইরে যেতে পারবে না → একই পদ্ধতি অনুসরণ করুন, তবে open-weight model নিন
পুরো পদ্ধতি: প্রতিবার চারটি ধাপ
- সমস্যার profile তৈরি করুন।
- Profile অনুযায়ী tier নির্ধারণ করুন।
- সেই tier থেকে ২-৩টি model shortlist করুন।
- নিজের eval-এর ফল দেখে সিদ্ধান্ত নিন।
কোনো একটি lab-এর প্রতি পক্ষপাত রাখার প্রয়োজন নেই, সেটি Anthropic, Google, OpenAI বা চীনের কোনো প্রতিষ্ঠান যা-ই হোক। আপনার task, আপনার ভাষা ও আপনার tone অনুযায়ী eval তৈরি করুন। দেখুন কোন model সবচেয়ে নির্ভুল ফল দিচ্ছে। তারপর eval নিয়মিত চালু রাখুন।
উদাহরণ: TaskFlow-তে একই product, তিনটি আলাদা model
Task | Profile | Tier | Model |
|---|---|---|---|
Task description-এর সারাংশ | সীমিত পরিসর, অত্যন্ত বেশি volume, user অপেক্ষারত | Fast | Haiku/Flash class, streamed |
"এই project তিন সপ্তাহ পিছিয়ে গেল কেন?" | জটিল, অনেক context, বিরল | Big, thinking on | Opus class |
Routing-এর জন্য request classify করা | সহজ, অত্যন্ত বেশি volume, তাৎক্ষণিক | যে সবচেয়ে ছোট model কাজ চালাতে পারে | Nano class বা small open-weight |
মাঝের প্রশ্নটি একটু বিশ্লেষণ করা যাক। তিন সপ্তাহে কোন task শুরু হয়েছে, কোনটি আটকে ছিল, কোনটি সম্পন্ন হয়েছে এবং কোন dependency-র কারণে কোনটি আটকে ছিল, এসব খুঁজে বের করতে হয়। এর জন্য বারবার একাধিক action নিতে হয়, আর প্রতিটি ধাপের ফলের ওপর ভিত্তি করে পরের ধাপ ঠিক হয়। তাই এখানে Big tier ও thinking on প্রয়োজন।
একই product, একই সময়, তিনটি আলাদা model। তখন "কোন model সবচেয়ে ভালো?" প্রশ্নটির আর কোনো অর্থ থাকে না।
Model Routing: প্রতিটি request-এ পদ্ধতিটি প্রয়োগ করুন
"কোন model সেরা?" এই প্রশ্ন বারবার করার পরিবর্তে একটি router তৈরি করা উচিত। আসা request দেখে router ঠিক করে দেয়, কোন model ব্যবহার হবে এবং কতটা thinking লাগবে:
Request | Router-এর সিদ্ধান্ত |
|---|---|
Deadline বের করো | Balanced/first tier (বেশিরভাগ traffic) |
Request classify করো | Nano/Small: সহজ ও তাৎক্ষণিক |
Priority tag করো | Nano/Small: সহজ ও তাৎক্ষণিক |
Client-কে উত্তরের খসড়া লেখো | Balanced/first tier |
Project তিন সপ্তাহ পিছিয়ে গেল কেন? | Big tier, thinking on: কঠিন ও বিরল অংশ |
ভাষা শনাক্ত করো | Fast tier |
মূল কথা হলো, একটি মাত্র model-এর ওপর নির্ভর করা ঠিক নয়। তাতে invoice অনেক বেড়ে যায়। Agent-গুলো এমনভাবে তৈরি করতে হবে, যাতে router-এর সিদ্ধান্ত অনুযায়ী কাজ সঠিক model-এ পৌঁছায়।
Invoice আসলে কীসের ওপর নির্ভর করে? (The Meter)
- Input বনাম output: Output-এর দাম কয়েক গুণ বেশি। Thinking-ও output হিসেবে bill হয়।
- Prompt caching: বারবার ব্যবহৃত prefix-এর দাম প্রায় এক-দশমাংশ। System prompt ও tool specification-এর মতো যেসব অংশ প্রায় বদলায় না, সেগুলো ওপরে রাখুন, আর user-এর prompt নিচে। তাহলে cache hit হবে। সঠিকভাবে সাজাতে না পারলে এই সুবিধা পাওয়া যায় না।
- Rate limit ও batch: Limit আছে ধরে নিয়েই design করুন। Offline কাজ batch-এ চালালে ছাড় পাওয়া যায়।
- Streaming: এটি সরাসরি invoice-এ বড় প্রভাব ফেলে না, কারণ streaming-এর জন্য আলাদা charge নেই। এটি generation-এর সময়কে user-এর কাছে দ্রুত অনুভূত হওয়ার রূপ দেয় (perceived speed)।
উপসংহার
এই পর্বের মূল বিষয়গুলো:
- Model-কে সাতটি parameter দিয়ে বিশ্লেষণ করুন: Capability, Cost, Speed, Latency, Context, Modality, Access।
- কোনো model-ই সাতটিতে সেরা নয়। Model নির্বাচন মানে কোন বিষয়ে ছাড় দেবেন, তা ঠিক করা।
- Frontier একটি অবস্থান, কোনো নির্দিষ্ট product নয়।
- Thinking একটি নিয়ন্ত্রণযোগ্য মাত্রা। সমস্যায় গভীর চিন্তার প্রয়োজন না থাকলে thinking tax দেবেন না।
- Match করুন, rank নয়। যে সবচেয়ে সাশ্রয়ী tier প্রয়োজনীয় মান পূরণ করে, সেটি নিন।
- চারটি ধাপ: Profile, Tier, Shortlist, নিজের Eval।
- একটি product-এ একাধিক model থাকবে, আর তাদের মাঝে একটি router।
এসব বিষয় জানা থাকলে নিজের product-এ AI সুচারুভাবে যুক্ত করা যায়, আবার অতিরিক্ত প্রচারণার (hype) প্রভাব থেকেও নিজেকে নিরাপদ রাখা যায়।
Right model, right task, every time.
পরবর্তী পর্বে: Prompt Engineering থেকে Context Engineering।
এই লেখা Stack Learner এর "AI Engineering 101" course এর Episode 4 থেকে নেওয়া আমার নোট। course এর সব credit Stack Learner এর। আপনি যদি পুরো জিনিসটা ঠিকভাবে শিখতে চান, তাদের কোর্সটা দেখার পরামর্শ রইল।
Was this useful?
Get the next one in your inbox
One email a month with the articles worth your time. No daily mail.
Written by
@noyonrahmanFull-Stack Developer
I'm Noyon Rahman — a software developer based in Dhaka, Bangladesh. I focus on backend development and API integration, designing and maintaining scalable APIs and integrating third-party services. I also contribute to frontend features when the team needs an extra pair of hands.
6 followersJoined Nov 30, 2024
Discussion
No comments yet
Join the discussion
Sign in to comment on this article. It takes a moment.
Be the first to comment
Questions and field notes are welcome. Help the next reader who finds this article.